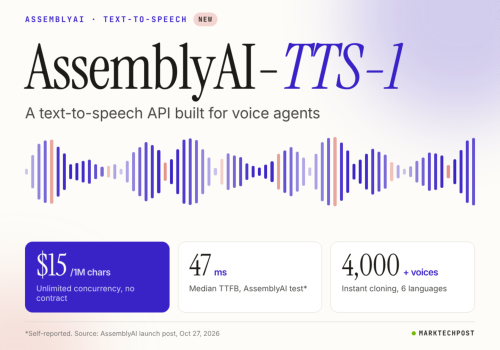
A AssemblyAI, uma das referências em APIs de reconhecimento de fala, acaba de lançar um produto que promete agitar o mercado de inteligência artificial conversacional: o AssemblyAI-TTS-1. Este é o primeiro modelo Text-to-Speech (TTS) da empresa, agora disponível para o público geral, e foi projetado especificamente para equipar agentes de voz que operam em chamadas telefônicas ao vivo. Em um cenário onde a velocidade de resposta e a clareza da pronúncia são cruciais, o AssemblyAI-TTS-1 entra em jogo com a promessa de transformar a interação entre humanos e IA.
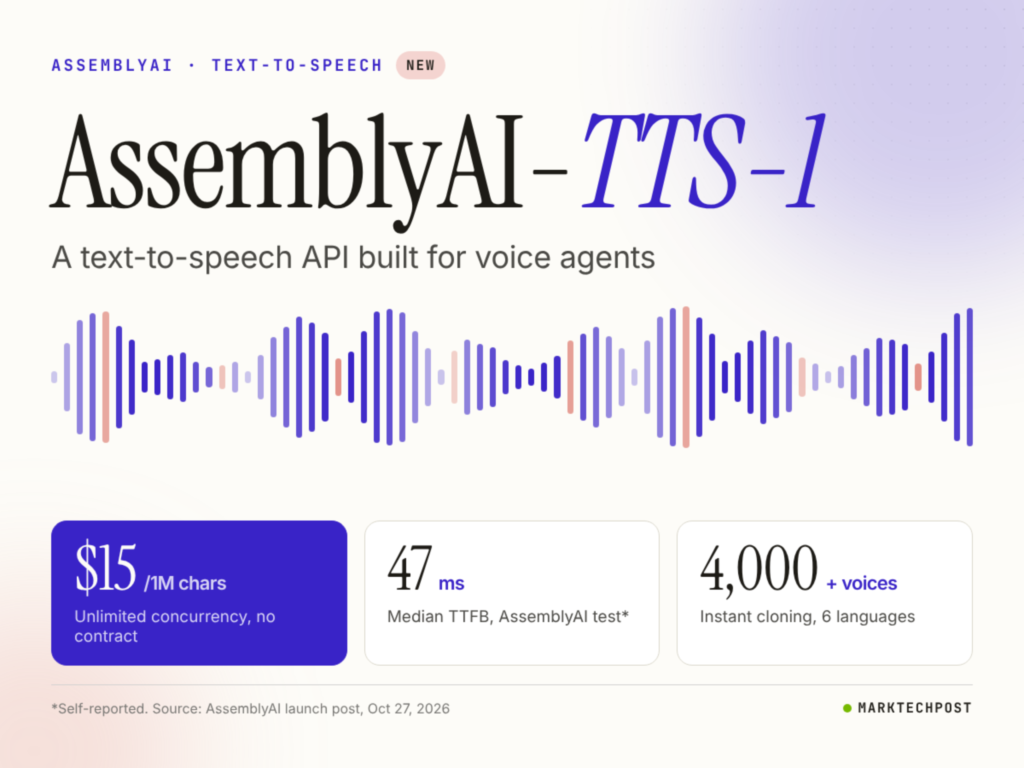
O grande diferencial desta nova API não reside apenas em sua tecnologia avançada, mas também em sua estrutura de preços altamente competitiva. Custando apenas US$ 15 por milhão de caracteres, sem contratos anuais e sem a necessidade de adquirir níveis de concorrência, a solução se posiciona como uma alternativa econômica e poderosa. Para desenvolvedores que já utilizam a tecnologia Speech-to-Text da AssemblyAI, o lançamento do AssemblyAI-TTS-1 representa o fechamento de um ciclo completo de voz, tudo sob um único fornecedor, simplificando a arquitetura e a gestão de projetos.
O Que É Exatamente o AssemblyAI-TTS-1?
O AssemblyAI-TTS-1 é um modelo de Text-to-Speech em streaming que converte as respostas de agentes de IA em fala, otimizado para chamadas ao vivo. Treinado com milhões de horas de áudio, incluindo dados de conversas reais, este modelo se destaca pela sua abordagem inovadora. Enquanto a maioria dos modelos TTS representa o áudio como tokens discretos, o AssemblyAI-TTS-1 opera com representações de áudio contínuas. A AssemblyAI afirma que essa técnica aprimora o realismo da voz sintetizada e, crucialmente, reduz o tempo até a primeira palavra falada (Time-to-First-Byte).
No lançamento, a API já oferece uma vasta biblioteca com mais de 4.000 vozes e a funcionalidade de clonagem instantânea de voz. Para criar um clone de voz, é necessário apenas uma gravação curta (no exemplo da empresa, 24 segundos de áudio foram suficientes) e a confirmação de permissão do falante. O suporte a idiomas é robusto desde o início, incluindo inglês, espanhol, francês, alemão, italiano e, um detalhe importante para o público brasileiro, o português.
Integração e Flexibilidade para Desenvolvedores com a API AssemblyAI-TTS-1
A AssemblyAI pensou na facilidade de integração para os desenvolvedores, oferecendo três interfaces principais para o AssemblyAI-TTS-1: uma API HTTP, uma API WebSocket e uma rota compatível com a API da OpenAI. A sessão WebSocket é particularmente útil para manter uma conexão por conversa e aceita mensagens de cancelamento para funcionalidades como o “barge-in” (interrupção do agente pelo usuário).
Em termos técnicos, a saída é em mono PCM, mu-law ou A-law, com taxas de amostragem que variam de 8 kHz a 48 kHz. O formato nativo é PCM de 24 kHz, mas stacks de telefonia podem solicitar diretamente mu-law de 8 kHz. A API também inclui timestamps de palavras, permitindo um controle mais preciso da sincronização. Para facilitar ainda mais, a AssemblyAI publicou agentes de referência LiveKit e Pipecat, demonstrando aplicações práticas.
Desempenho: O AssemblyAI-TTS-1 em Comparação com a Concorrência
A AssemblyAI conduziu testes rigorosos, comparando o TTS-1 com cinco outros modelos em quatro conjuntos de dados em inglês, usando 50 vozes clonadas correspondentes. Os resultados são bastante promissores (dados auto-relatados, de outubro de 2026):
Precisão de Entidades: 93,7%, superando o ElevenLabs v4 (93,6%), Cartesia Sonic 3.6 (82,5%) e ElevenLabs Flash v2.5 (68,0%) em alvos difíceis como números de telefone e códigos.Precisão de Palavras: 99,0% em sentenças Seed-TTS e LibriSpeech.MOS (Mean Opinion Score) Predito: 3,85, ficando ligeiramente atrás do Inworld TTS-2 Flash (3,88), mas à frente do Sonic 3.6 (3,82).Tempo Mediano para o Primeiro Byte (TTFB): Impressionantes 47 ms, significativamente mais rápido que Flash v2.5 (119 ms), Sonic 3.6 (143 ms) e Inworld TTS-2 Flash (244 ms).Outros Indicadores: 85,5 no escore de prosódia TTSDS e 0,64 de similaridade de locutor para áudio clonado.
Entretanto, resultados independentes mostram um cenário mais matizado. Em um benchmark da Cekura com 27 modelos, o AssemblyAI-TTS-1 obteve 81,5% de precisão de leitura e 4,50 de naturalidade. Sua latência mediana de streaming, medida a partir da última palavra enviada, foi de 159 ms. Para comparação, o Inworld TTS-2 Flash registrou 45 ms e 93,2% de precisão, com o mesmo preço de US$ 15 por milhão de caracteres. A AssemblyAI também cita uma taxa de erro de palavra de 1,7% no leaderboard da Coval e uma estreia entre os 10 melhores na arena de voz controlada da Artificial Analysis.
Por Que o Lançamento do AssemblyAI-TTS-1 Importa?
O impacto do AssemblyAI-TTS-1 no mercado de IA conversacional é multifacetado. Primeiro, o preço agressivo de US$ 15 por 1 milhão de caracteres, combinado com concorrência ilimitada, democratiza o acesso a tecnologia TTS de alta qualidade. Isso significa que startups e pequenas empresas podem implementar agentes de voz sofisticados sem comprometer orçamentos massivos.
Em segundo lugar, a baixa latência é um divisor de águas para aplicações de voz em tempo real. Em chamadas telefônicas, mesmo milissegundos podem fazer a diferença entre uma interação natural e uma robótica. A capacidade do AssemblyAI-TTS-1 de entregar o primeiro áudio rapidamente melhora drasticamente a experiência do usuário, tornando os agentes de voz mais eficazes e menos frustrantes. Para os desenvolvedores que já usam outras soluções da AssemblyAI, a integração de voz de ponta a ponta otimiza o fluxo de trabalho e reduz a complexidade de gerenciar múltiplos fornecedores.
Limitações Atuais e o Que Esperar do Futuro
Apesar de suas impressionantes capacidades, o AssemblyAI-TTS-1 ainda apresenta algumas limitações no momento do lançamento. Notavelmente, não há suporte para SSML (Speech Synthesis Markup Language), controle de velocidade de fala, dicionários de pronúncia personalizados ou tags de emoção. Essas funcionalidades são cruciais para um controle mais granular e expressividade da voz sintetizada, especialmente em cenários que exigem nuances complexas de fala.
É provável que a AssemblyAI implemente essas características em futuras atualizações, já que são recursos padrão em muitas outras soluções TTS avançadas. A trajetória da empresa sugere um compromisso contínuo com a inovação, e a evolução do AssemblyAI-TTS-1 deve seguir de perto as demandas do mercado e as tendências em IA generativa de voz. A competição acirrada com empresas como ElevenLabs e Inworld certamente impulsionará melhorias contínuas.
Conclusão: Um Novo Marco para Agentes de Voz
O lançamento do AssemblyAI-TTS-1 marca um avanço significativo no campo das tecnologias de Text-to-Speech, especialmente para aplicações de agentes de voz em tempo real. Ao combinar um preço acessível com um desempenho de latência impressionante e alta precisão, a AssemblyAI está capacitando desenvolvedores a criar experiências conversacionais mais naturais e eficientes. Embora algumas funcionalidades avançadas ainda estejam por vir, o potencial de transformar o atendimento ao cliente, assistentes virtuais e outras interfaces de voz é inegável. Este é um passo importante para a democratização da IA de voz de ponta, solidificando a posição da AssemblyAI como uma inovadora chave no ecossistema da inteligência artificial.
FAQ: Perguntas Frequentes sobre o AssemblyAI-TTS-1
Qual é o principal diferencial de preço do AssemblyAI-TTS-1?
O principal diferencial é o custo de US$ 15 por milhão de caracteres, sem a necessidade de contratos anuais ou taxas adicionais por concorrência. Isso o torna uma opção muito econômica para empresas e desenvolvedores que buscam soluções TTS de alta qualidade.
O AssemblyAI-TTS-1 suporta clonagem de voz?
Sim, o AssemblyAI-TTS-1 oferece clonagem instantânea de voz. Para isso, é preciso uma gravação de áudio curta do locutor (a AssemblyAI mencionou 24 segundos como exemplo) e a permissão confirmada do indivíduo cuja voz será clonada.
Gostou da notícia?
Inscreva-se na nossa newsletter e receba as principais novidades sobre inteligência artificial diretamente no seu e-mail.
Fonte: https://www.marktechpost.com