A Inteligência Artificial continua a surpreender com avanços que redefinem o que é possível. No epicentro dessa inovação, o Google Gemini Omni surge como um marco. Anunciado como um membro da família de modelos generativos Gemini, sua proposta é revolucionária: gerar resultados a partir de qualquer combinação de tipos de entrada, começando com a análise aprofundada de vídeos. Mas o que isso realmente significa para o futuro da IA, como funciona e quais são os impactos práticos de um modelo com capacidades tão abrangentes?
O Que É o Google Gemini Omni e Sua Proposta Multimodal
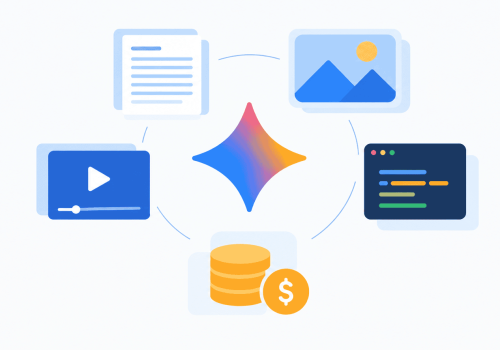
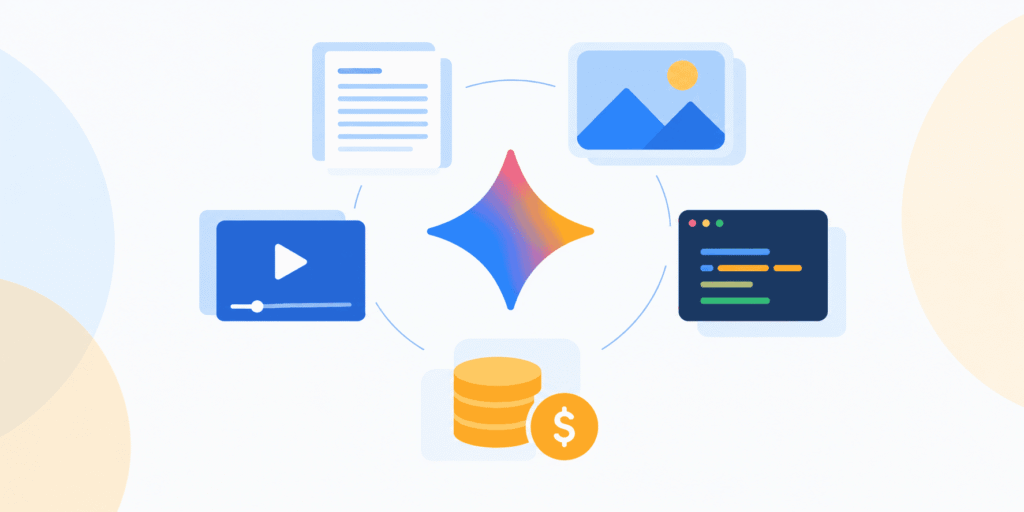
O Google Gemini Omni representa a vanguarda dos modelos de IA generativa, projetado para transcender as limitações dos modelos que trabalham com uma única modalidade de dados, como texto ou imagem. A promessa central é sua capacidade de sintetizar informações de diversos tipos de entrada simultaneamente — texto, imagens, áudio e, crucialmente, vídeo — para gerar saídas coerentes e contextualmente relevantes.
Enquanto muitos modelos multimodais já conseguem integrar texto e imagem, a verdadeira inovação do Gemini Omni reside em sua habilidade de processar o vídeo como um de seus inputs primários. Isso significa que ele não apenas “vê” as cenas, mas também “ouve” os sons e “entende” a sequência temporal dos eventos, oferecendo uma compreensão muito mais rica e dinâmica do conteúdo.
Para Além do Texto e Imagem: A Importância do Vídeo no Gemini Omni
A capacidade de processar vídeo de forma nativa e integrada é um divisor de águas. O vídeo é a forma de mídia mais rica em informações, combinando movimento, som, tempo e narrativa. Um modelo como o Google Gemini Omni pode extrair nuances que seriam impossíveis de obter apenas com frames estáticos ou transcrições de áudio. Imagine a IA não apenas identificando objetos em uma imagem, mas compreendendo a intenção por trás de um movimento em um vídeo, o tom de uma voz em um diálogo ou a emoção expressa em uma sequência de eventos. Essa compreensão holística abre portas para aplicações que antes pareciam ficção científica.
Como o Gemini Omni Funciona (em Termos Simples)
Embora os detalhes técnicos exatos de sua arquitetura sejam complexos e patenteados, o princípio fundamental do Gemini Omni baseia-se na criação de um modelo unificado capaz de aprender representações interligadas para diferentes modalidades. Em vez de ter módulos separados para texto, visão e áudio que depois tentam se comunicar, o Gemini Omni é treinado para compreender todas essas informações em um espaço de representação compartilhado.
Isso permite que ele “raciocine” sobre as relações entre o que vê, ouve e lê, levando a uma inteligência mais coerente e robusta. Por exemplo, ao analisar um vídeo, o modelo não apenas transcreve a fala, mas também correlaciona essa fala com as expressões faciais dos interlocutores, os objetos no cenário e o contexto da ação, construindo uma interpretação muito mais completa e precisa do evento.
Por Que o Google Gemini Omni Importa: Aplicações e Impactos
A chegada de um modelo como o Google Gemini Omni não é apenas uma notícia para a comunidade de pesquisa em IA; é um catalisador para a transformação em inúmeros setores e para a maneira como interagimos com a tecnologia em nosso dia a dia. Suas capacidades multimodais avançadas prometem desbloquear novas formas de criatividade, eficiência e acessibilidade.
Transformando Indústrias com a IA Multimodal
As aplicações potenciais são vastíssimas e impactarão diretamente diversas indústrias:
Mídia e Entretenimento: Edição de vídeo automatizada, criação de conteúdo interativo, legendagem e dublagem inteligentes, análise de desempenho de atores, e até mesmo a geração de conteúdo audiovisual completo a partir de descrições textuais detalhadas.Saúde: Análise de vídeos cirúrgicos para treinamento e assistência, diagnóstico precoce de condições neurológicas através da análise de movimentos e fala, monitoramento de pacientes com base em sinais visuais e auditivos.Educação: Tutoria interativa que reage não apenas às respostas textuais, mas também às expressões faciais de confusão ou compreensão dos alunos em videochamadas, criação de materiais didáticos dinâmicos e personalizados.Segurança e Vigilância: Análise de eventos complexos em tempo real, identificação de comportamentos suspeitos, e até mesmo a reconstrução de cenários a partir de múltiplas fontes de vídeo e áudio.Atendimento ao Cliente: Chatbots mais empáticos que compreendem não só o texto digitado, mas também o tom de voz e as emoções do cliente em chamadas ou videochamadas.
Impacto para Desenvolvedores e Empresas
Para desenvolvedores, o Gemini Omni representa um novo conjunto de ferramentas para construir aplicações mais inteligentes e intuitivas. Ele permite a criação de AI Agents que podem interagir com o mundo de forma mais humana, processando o ambiente de forma contextualizada. Empresas poderão automatizar processos complexos que antes exigiam análise humana detalhada de dados multimodais, desde o controle de qualidade em linhas de produção até a criação de campanhas de marketing personalizadas com base em análises profundas de engajamento do usuário em vídeo.
O Custo do Google Gemini Omni: Primeiras Expectativas
O título original da notícia mencionava o custo, mas como é comum em lançamentos de tecnologias de ponta, detalhes específicos de precificação do Google Gemini Omni geralmente são divulgados à medida que o modelo se torna mais amplamente disponível para desenvolvedores e empresas. No entanto, podemos inferir o modelo de precificação com base em outras ofertas de IA do Google Cloud e do mercado em geral.
É provável que o Gemini Omni siga um modelo de pagamento por uso (pay-as-you-go), onde os custos são calculados com base na quantidade de dados processados (por exemplo, tempo de vídeo, número de tokens de texto, complexidade das requisições). Poderão existir diferentes tiers de acesso, com opções mais acessíveis para pequenos desenvolvedores e startups, e planos empresariais com suporte dedicado e volumes maiores. A otimização de custos e a eficiência do uso dos recursos computacionais serão fatores cruciais para a adoção em larga escala.
Gemini Omni no Cenário da IA: Uma Comparação
A paisagem da IA multimodal é altamente competitiva, com empresas como OpenAI, Anthropic e Meta também investindo pesado em suas próprias capacidades. No entanto, a descrição do Google Gemini Omni com foco em “qualquer combinação de input” e sua ênfase inicial em vídeo o posicionam como um player formidável.
Enquanto modelos como o GPT-4o da OpenAI demonstram capacidades multimodais impressionantes (texto, áudio, imagem), a menção explícita de vídeo como ponto de partida para o Gemini Omni sugere uma profundidade de compreensão temporal e contextual que pode ser um diferencial. A capacidade de processar longas sequências de vídeo, entender narrativas complexas e interações dinâmicas sem a necessidade de pré-processamento manual pode dar ao Gemini Omni uma vantagem em nichos específicos, como a análise de mídias ricas e a criação de conteúdo audiovisual avançado.
O Que Esperar do Futuro do Google Gemini Omni
O lançamento do Google Gemini Omni é apenas o começo. Podemos esperar uma rápida evolução em suas capacidades, com melhorias contínuas na precisão da análise multimodal, na fluidez das respostas e na integração com outras ferramentas e plataformas. A tendência é que modelos como o Gemini Omni se tornem a base para a próxima geração de assistentes de IA, sistemas de automação e interfaces de usuário mais naturais e intuitivas.
O Google tem um histórico robusto em pesquisa de IA e infraestrutura em nuvem, o que o posiciona bem para escalar e refinar o Gemini Omni. À medida que mais desenvolvedores começarem a explorar suas APIs, novas aplicações e casos de uso inesperados surgirão, solidificando o papel da IA multimodal como um pilar essencial da transformação digital. No entanto, desafios como a segurança, a ética no uso de dados sensíveis e o consumo de recursos computacionais continuarão sendo áreas de foco para o desenvolvimento responsável.
Conclusão
O Google Gemini Omni não é apenas mais um modelo de IA; é um passo significativo em direção a uma inteligência artificial verdadeiramente compreensiva e interativa. Sua capacidade de processar e gerar resultados a partir de qualquer combinação de inputs multimodais, com um foco especial no vídeo, promete desbloquear um universo de novas aplicações e transformar a maneira como interagimos com o mundo digital e físico. À medida que a tecnologia amadurece, veremos a IA se integrar de forma ainda mais profunda e natural em nossas vidas, potencializando a criatividade humana e resolvendo desafios complexos com uma inteligência sem precedentes.
FAQ: Perguntas Frequentes sobre o Google Gemini Omni
1. O que diferencia o Google Gemini Omni de outros modelos de IA multimodal?
A principal distinção do Google Gemini Omni é sua arquitetura projetada para processar “qualquer combinação de tipos de entrada” (texto, imagem, áudio, vídeo) de forma unificada, com um foco inicial e robusto na compreensão e geração a partir de vídeo. Isso permite uma interpretação mais profunda e contextualizada de eventos dinâmicos.
2. Quais são as principais aplicações potenciais do Gemini Omni?
As aplicações do Gemini Omni são vastas e incluem: análise avançada de conteúdo de vídeo (edição, sumários, classificação), criação de assistentes inteligentes para criadores de conteúdo, diagnósticos médicos e monitoramento de pacientes através de vídeo, tutoria educacional interativa que reage a expressões e fala, e sistemas de segurança e vigilância mais inteligentes. É um modelo chave para a próxima geração de AI Agents.
Gostou da notícia?
Inscreva-se na nossa newsletter e receba as principais novidades sobre inteligência artificial diretamente no seu e-mail.
Fonte: https://www.kdnuggets.com