A Inteligência Artificial (IA) tem revolucionado a forma como interagimos com a informação. No entanto, os modelos de linguagem grandes (LLMs), apesar de sua capacidade impressionante de gerar e compreender texto, possuem limitações inerentes: eles podem ‘alucinar’ informações e seu conhecimento é restrito aos dados em que foram treinados. Para mitigar esses desafios, a técnica de Retrieval Augmented Generation (RAG) surgiu como uma solução poderosa, permitindo que os LLMs consultem uma base de conhecimento externa e atualizada. Mas o que acontece quando essa base de conhecimento não é apenas textual, mas também visual? É aqui que o pipeline RAG multimodal entra em cena, transformando a maneira como os modelos de IA interagem com o mundo real.
Neste artigo aprofundado, você aprenderá a construir um pipeline RAG multimodal em Python, capaz de buscar e raciocinar sobre informações extraídas de textos e imagens. Vamos explorar desde os conceitos fundamentais até as etapas práticas para implementar essa tecnologia de ponta, garantindo que seus sistemas de IA possam ir muito além do texto puro, compreendendo o contexto completo de seus dados.
O Que é um Pipeline RAG Multimodal e Por Que Ele Importa?
Para entender um pipeline RAG multimodal, é crucial primeiro relembrar o conceito de RAG tradicional. O RAG permite que um LLM recupere informações relevantes de um vasto banco de dados (documentos, artigos, páginas web) antes de gerar uma resposta. Isso reduz as alucinações, fornece respostas mais precisas e permite que o LLMs acessem conhecimentos mais recentes do que seu conjunto de treinamento original.
A adição da palavra ‘multimodal’ significa que o sistema não se limita apenas a dados textuais. Ele pode processar e raciocinar sobre diferentes tipos de dados, como imagens, áudio, vídeo e, no nosso caso, especificamente imagens e documentos. Imagine um cenário onde você precisa responder a uma pergunta que exige a interpretação tanto de um gráfico em um relatório (imagem) quanto do texto descritivo ao redor (documento). Um RAG tradicional falharia em extrair o contexto visual, enquanto um sistema multimodal pode integrar essas duas fontes de informação para uma compreensão mais completa.
A Relevância da Abordagem RAG Multimodal para Empresas e Desenvolvedores
A capacidade de lidar com múltiplas modalidades é um divisor de águas. Para empresas, significa que a IA pode extrair valor de um espectro muito mais amplo de dados. Setores como saúde (análise de imagens médicas e históricos de pacientes), e-commerce (descrição de produtos baseada em imagens e avaliações), ou manufatura (inspeção visual e manuais técnicos) se beneficiam enormemente. Desenvolvedores ganham ferramentas para criar aplicações de IA mais robustas, inteligentes e capazes de imitar melhor a compreensão humana do mundo, que é intrinsecamente multimodal.
Como Funciona um Pipeline RAG Multimodal: Arquitetura e Componentes Chave
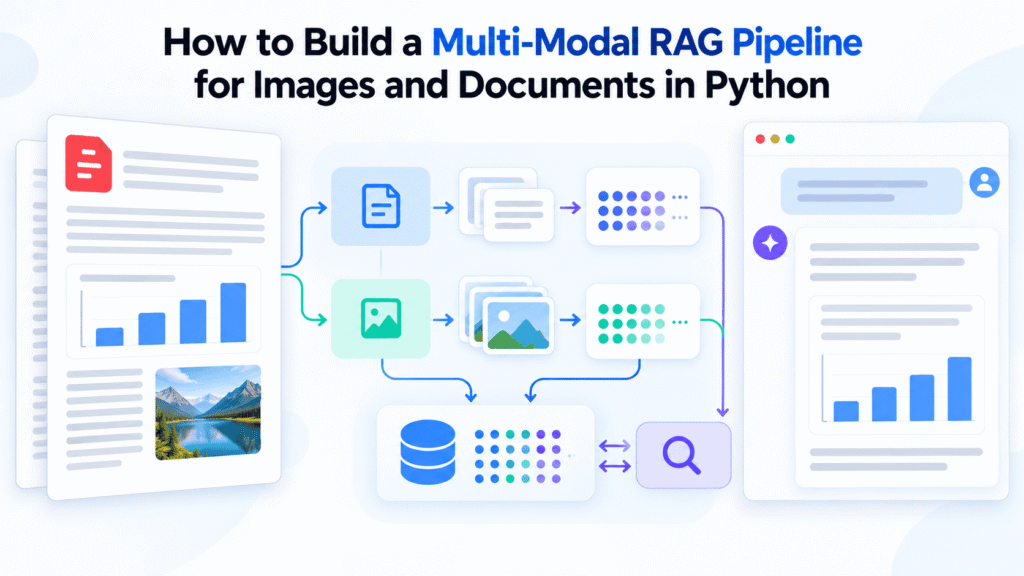
A arquitetura de um pipeline RAG multimodal se assemelha à de um RAG convencional, mas com adaptações cruciais para o processamento de diferentes tipos de dados. Os principais componentes incluem:
Processamento e Extração de Dados: Nesta etapa, documentos são pré-processados para extrair texto (usando OCR para imagens incorporadas), e imagens são carregadas diretamente.Geração de Embeddings Multimodais: Esta é a etapa central e a que diferencia o RAG multimodal. Em vez de embeddings apenas textuais, usamos modelos que podem gerar representações vetoriais de texto e imagens em um espaço de embedding unificado. Isso significa que um texto descrevendo uma imagem e a própria imagem estarão ‘próximos’ nesse espaço vetorial.Banco de Vetores (Vector Database): Os embeddings multimodais são armazenados em um banco de dados de vetores, otimizado para buscas de similaridade eficiente.Mecanismo de Recuperação (Retrieval): Dada uma consulta (que pode ser texto, imagem, ou ambos), o sistema busca os embeddings mais similares no banco de vetores.Geração Aumentada por LLM: Os dados recuperados (textos e metadados de imagens) são fornecidos ao LLM, que então gera uma resposta informada pelo contexto multimodal.
Embeddings Multimodais: A Ponte entre Texto e Imagem
O segredo para um pipeline RAG multimodal eficaz reside nos embeddings multimodais. Modelos como CLIP (Contrastive Language–Image Pre-training) da OpenAI são exemplos pioneiros. Eles aprendem a mapear imagens e textos para o mesmo espaço vetorial, de modo que pares de imagem-texto semanticamente relacionados tenham embeddings vetoriais semelhantes. Isso permite que uma consulta textual recupere imagens relevantes, e vice-versa, ou que uma consulta multimodal combine elementos de ambos.
Construindo Seu Pipeline RAG Multimodal em Python: Um Guia Prático
A construção de um pipeline RAG multimodal em Python envolve diversas bibliotecas e frameworks. Embora não seja possível detalhar todo o código aqui, vamos delinear as etapas essenciais e as ferramentas que você pode utilizar.
1. Preparação dos Dados: Textos e Imagens
Documentos: Para arquivos PDF ou outros formatos, use bibliotecas como PyPDF2 ou pdfminer.six para extrair texto. Considere o uso de OCR (Optical Character Recognition) com Tesseract (via pytesseract) ou serviços de nuvem (Google Cloud Vision, AWS Textract) para extrair texto de imagens dentro dos documentos.Imagens: Carregue as imagens usando PIL (Pillow) ou OpenCV. Certifique-se de que estão em um formato e resolução adequados para o modelo de embedding.
2. Geração de Embeddings Multimodais
Utilize modelos pré-treinados para gerar embeddings. Bibliotecas como Hugging Face Transformers fornecem acesso fácil a modelos como CLIP ou outros encoders multimodais. Você pode usar a API de modelos, por exemplo, para CLIP:
from transformers import CLIPProcessor, CLIPModel
model = CLIPModel.from_pretrained(“openai/clip-vit-base-patch32”)
processor = CLIPProcessor.from_pretrained(“openai/clip-vit-base-patch32”)
// Para uma imagem:
image_features = model.get_image_features(**processor(images=image, return_tensors=”pt”))
// Para um texto:
text_features = model.get_text_features(**processor(text=text, return_tensors=”pt”))
3. Armazenamento e Recuperação de Vetores
Escolha um banco de vetores que suporte buscas de similaridade eficientes. Opções populares incluem:
Pinecone, Weaviate, Qdrant: Bancos de dados de vetores gerenciados na nuvem, ideais para produção.Chroma DB, FAISS (Facebook AI Similarity Search): Opções open-source para uso local ou em escala menor.
Você indexará os embeddings gerados (tanto de texto quanto de imagens) juntamente com os metadados associados (texto original, caminho da imagem, etc.) para que possam ser recuperados posteriormente.
4. Orquestração com LLMs
Para a etapa final, integre a recuperação com um LLM. Frameworks como LangChain ou LlamaIndex são excelentes para orquestrar essa complexidade. Eles permitem que você defina cadeias de processos onde a consulta do usuário é primeiramente usada para recuperar informações relevantes (texto e metadados de imagem) do seu banco de vetores. Em seguida, essas informações são formatadas e injetadas no prompt do LLM, que então gera uma resposta coerente e contextualmente rica.
Por exemplo, você pode criar um prompt que diga: ‘Com base nas seguintes informações de texto: [textos recuperados] e com as seguintes referências visuais: [descrições/metadados de imagens recuperadas], responda à pergunta: [pergunta do usuário].’
Desafios e Oportunidades no Desenvolvimento de um RAG Multimodal
Embora o potencial do pipeline RAG multimodal seja imenso, existem desafios a serem considerados:
Alinhamento de Dados: Garantir que os embeddings multimodais representem com precisão a relação entre diferentes modalidades pode ser complexo.Custo Computacional: Gerar e armazenar embeddings para grandes volumes de imagens e textos é intensivo em recursos.Qualidade dos Dados: A performance do sistema depende diretamente da qualidade dos dados de entrada (imagens claras, texto bem extraído).Interpretabilidade: Entender por que o modelo de IA fez certas conexões multimodais pode ser difícil.
No entanto, as oportunidades superam os desafios. A capacidade de construir sistemas de IA que ‘veem’ e ‘leem’ ao mesmo tempo abre portas para inovações em quase todos os setores, desde a automação de processos até a criação de assistentes inteligentes verdadeiramente contextuais.
O Futuro da Recuperação de Informações com IA
O pipeline RAG multimodal representa um passo significativo em direção a sistemas de IA mais versáteis e confiáveis. À medida que os modelos de embedding multimodais se tornam mais sofisticados e eficientes, e os frameworks de orquestração se integram ainda mais, veremos uma proliferação de aplicações que aproveitam a riqueza de dados multimodais para resolver problemas complexos do mundo real. É uma área de pesquisa e desenvolvimento em rápida evolução, prometendo revolucionar a forma como interagimos com a informação digital.
Para aprofundar seus conhecimentos em RAG, considere ler nosso artigo sobre como otimizar prompts para LLMs com RAG.
Conclusão
Construir um pipeline RAG multimodal para imagens e documentos em Python é uma habilidade valiosa no cenário atual da Inteligência Artificial. Ao unir a capacidade de compreensão textual dos LLMs com a riqueza das informações visuais, você capacita seus sistemas de IA a operar com um nível de contexto e precisão antes inatingível. Com as ferramentas e conceitos apresentados, você tem um ponto de partida sólido para começar a explorar e implementar essa tecnologia transformadora em seus próprios projetos.
FAQ: Perguntas Frequentes sobre Pipeline RAG Multimodal
O que é um embedding multimodal?
Um embedding multimodal é uma representação vetorial (numérica) que encapsula o significado semântico de diferentes tipos de dados, como texto e imagens, em um mesmo espaço dimensional. Isso permite que um modelo de IA compare e encontre relações de similaridade entre um texto e uma imagem, por exemplo, ou entre duas modalidades distintas.
Qual a principal vantagem de usar um RAG multimodal sobre um RAG tradicional?
A principal vantagem é a capacidade de um pipeline RAG multimodal de interpretar e raciocinar sobre informações que abrangem tanto o texto quanto o conteúdo visual. Enquanto um RAG tradicional só pode buscar e utilizar informações textuais, o RAG multimodal oferece uma compreensão mais rica e completa do contexto, resultando em respostas mais precisas e informativas para consultas complexas que dependem de ambas as modalidades. Saiba mais sobre RAG em geral na documentação da LlamaIndex.
Gostou da notícia?
Inscreva-se na nossa newsletter e receba as principais novidades sobre inteligência artificial diretamente no seu e-mail.