No universo dinâmico da Inteligência Artificial, a eficiência e a velocidade são cruciais, especialmente quando falamos de Small Language Models (SLMs) e Large Language Models (LLMs). À medida que esses modelos se tornam mais integrados em diversas aplicações, a necessidade de otimizar sua performance e custo de inferência cresce exponencialmente. Uma técnica que tem ganhado destaque e que abordamos em profundidade neste artigo é a Reutilização de Prefixo de Prompt com Cache Key-Value. Esta abordagem não apenas promete revolucionar a forma como interagimos com os modelos de linguagem, mas também apresenta um caminho claro para uma IA mais acessível e responsiva.
O Desafio da Inferência em Modelos de Linguagem e a Busca por Otimização
Desenvolver e implantar LLMs e SLMs é apenas metade da batalha. O verdadeiro desafio reside em operá-los de forma eficiente em larga escala. A inferência, ou seja, o processo de gerar uma resposta a partir de um prompt, pode ser computacionalmente intensiva e custosa. Cada vez que um modelo gera um token de saída, ele precisa processar o prompt de entrada e todos os tokens já gerados. Em cenários onde há prompts longos ou interações sequenciais, isso se traduz em latência elevada e consumo significativo de recursos.
A demanda por resultados rápidos e a necessidade de reduzir custos operacionais têm impulsionado a pesquisa por técnicas inovadoras de otimização. É nesse contexto que a ideia de reutilizar partes do processamento se torna extremamente atraente, e é aqui que o conceito de prefixo de prompt e cache Key-Value entra em cena.
Entendendo o Prefixo de Prompt: A Base da Reutilização
Um prompt em um modelo de linguagem muitas vezes contém uma seção inicial que se repete ou é comum em várias requisições. Chamamos essa seção de prefixo de prompt. Pense, por exemplo, em um assistente de IA que sempre começa com a frase “Você é um assistente útil e prestativo” ou em um sistema de atendimento ao cliente que sempre contextualiza a conversa com “Considerando o histórico do cliente X…”. Esses são exemplos claros de prefixos de prompt.
Em muitas aplicações, os usuários interagem com LLMs ou SLMs em um fluxo conversacional, onde as informações anteriores são mantidas como parte do prompt para manter o contexto. Ou, em cenários multi-turn, onde o sistema pode ter um prompt base que é ligeiramente modificado para cada nova pergunta. Processar repetidamente essa parte inicial do prompt é um desperdício de recursos computacionais e tempo.
Por Que Reutilizar o Prefixo?
A reutilização do prefixo de prompt visa evitar o reprocessamento desnecessário dessa parte estável do prompt. Ao identificar e armazenar o resultado do processamento do prefixo, podemos economizar ciclos de CPU e GPU, diminuindo a latência e o consumo de energia. Isso é especialmente relevante para aplicações em tempo real e para a escalabilidade de serviços baseados em IA.
Cache Key-Value: A Arquitetura por Trás da Eficiência na Otimização de SLMs
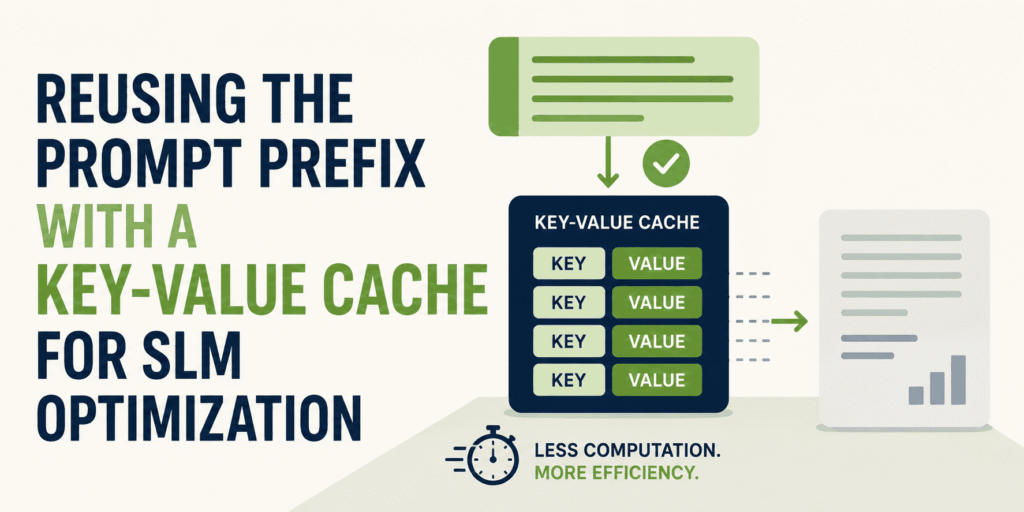
A mágica da reutilização acontece através da implementação de um Cache Key-Value. No contexto de modelos de linguagem baseados em arquiteturas Transformer (como a maioria dos LLMs e SLMs), cada token do prompt é processado para gerar ‘chaves’ (keys) e ‘valores’ (values). Esses keys e values são componentes essenciais no mecanismo de atenção do Transformer, que determina como o modelo ‘pesa’ a importância de diferentes partes da entrada ao gerar a saída.
Um cache Key-Value, portanto, é um armazenamento onde salvamos os pares de chaves e valores calculados para o prefixo de prompt. Quando um novo prompt chega, o sistema primeiro verifica se o seu prefixo já foi processado e armazenado em cache. Se sim, ele recupera os keys e values pré-computados e os ‘anexa’ aos keys e values gerados para a parte nova do prompt, evitando assim o cálculo desde o início.
Mecanismo em Detalhe
Essa técnica é particularmente eficaz porque o cálculo dos pares Key-Value para tokens anteriores é uma das operações mais custosas em termos de memória e computação durante a fase de inferência de um modelo Transformer. Reutilizá-los diretamente do cache elimina a necessidade de recomputação.
Impacto Prático e Vantagens da Reutilização de Prefixo de Prompt com Cache Key-Value
A implementação da reutilização de prefixo de prompt com cache Key-Value traz uma série de benefícios tangíveis para desenvolvedores, empresas e usuários finais.
Essa técnica se alinha perfeitamente com a crescente demanda por LLMs e SLMs mais leves e ágeis, que possam ser implantados em ambientes com recursos limitados ou que exijam respostas ultra-rápidas.
Desafios e Considerações na Implementação do Cache Key-Value
Embora a reutilização de prefixo de prompt com cache Key-Value ofereça vantagens substanciais, sua implementação não está isenta de desafios. É crucial considerar alguns pontos para garantir a eficácia e a estabilidade do sistema.
Estudos e ferramentas recentes têm focado em como gerenciar esses caches de forma inteligente, adaptando-se aos padrões de uso e garantindo que os benefícios superem os custos de manutenção do cache. Para aprofundar-se mais nos detalhes técnicos do caching em arquiteturas Transformer, você pode consultar recursos como a documentação de bibliotecas de inferência otimizada ou artigos de pesquisa sobre o assunto como este da Hugging Face sobre KV-Cache.
O Futuro da Otimização de SLMs e o Papel Contínuo do Caching
A otimização de Small Language Models é um campo em constante evolução. Além da reutilização de prefixo de prompt com cache Key-Value, outras técnicas como quantização, poda (pruning) e destilação de modelos continuam sendo exploradas para tornar os SLMs ainda mais eficientes. No entanto, o caching, em suas diversas formas, permanecerá um pilar fundamental na busca por inferência de baixo custo e alta velocidade.
A medida que os SLMs são implementados em dispositivos edge e em cenários de tempo real, a capacidade de reduzir a carga computacional por meio da reutilização inteligente de recursos, como o cache Key-Value, será um diferencial competitivo. Essa técnica não é apenas uma melhoria incremental, mas uma mudança de paradigma na forma como pensamos a arquitetura de inferência de modelos de linguagem.
Para entender melhor como as otimizações gerais impactam o desempenho de modelos, você pode conferir nosso artigo sobre as mais recentes inovações em SLMs e seus usos.
Conclusão
A reutilização de prefixo de prompt com cache Key-Value é uma estratégia poderosa e cada vez mais essencial para a otimização de SLMs e LLMs. Ao focar na eficiência do processamento de entrada, ela oferece ganhos significativos em termos de latência e custo, abrindo caminho para aplicações de IA mais robustas, escaláveis e amigáveis ao usuário. Dominar e implementar essa técnica será um diferencial para qualquer organização que busca extrair o máximo valor de seus modelos de linguagem.
FAQ: Perguntas Frequentes sobre Reutilização de Prefixo de Prompt e Cache Key-Value
1. O que é exatamente um prefixo de prompt em SLMs?
Um prefixo de prompt é a parte inicial de um prompt de entrada que se mantém constante ou se repete em várias interações com um Small Language Model (SLM) ou Large Language Model (LLM). É o contexto ou instrução base que é fornecida ao modelo antes da parte específica da pergunta ou tarefa. Exemplo: ‘Você é um assistente de IA prestativo. Responda à seguinte pergunta: [pergunta aqui]’. A primeira frase é o prefixo.
2. Como o cache Key-Value ajuda na otimização da inferência de SLMs?
O cache Key-Value armazena os resultados intermediários (pares de chaves e valores) do processamento do prefixo de prompt pelo modelo Transformer. Em vez de recomputar esses valores para cada nova requisição que compartilha o mesmo prefixo, o sistema recupera-os diretamente do cache. Isso evita computações redundantes, resultando em menor latência, menor consumo de recursos e, consequentemente, menores custos operacionais para a inferência de SLMs.
Gostou da notícia?
Inscreva-se na nossa newsletter e receba as principais novidades sobre inteligência artificial diretamente no seu e-mail.
Fonte: https://www.kdnuggets.com