setembro 20, 2026

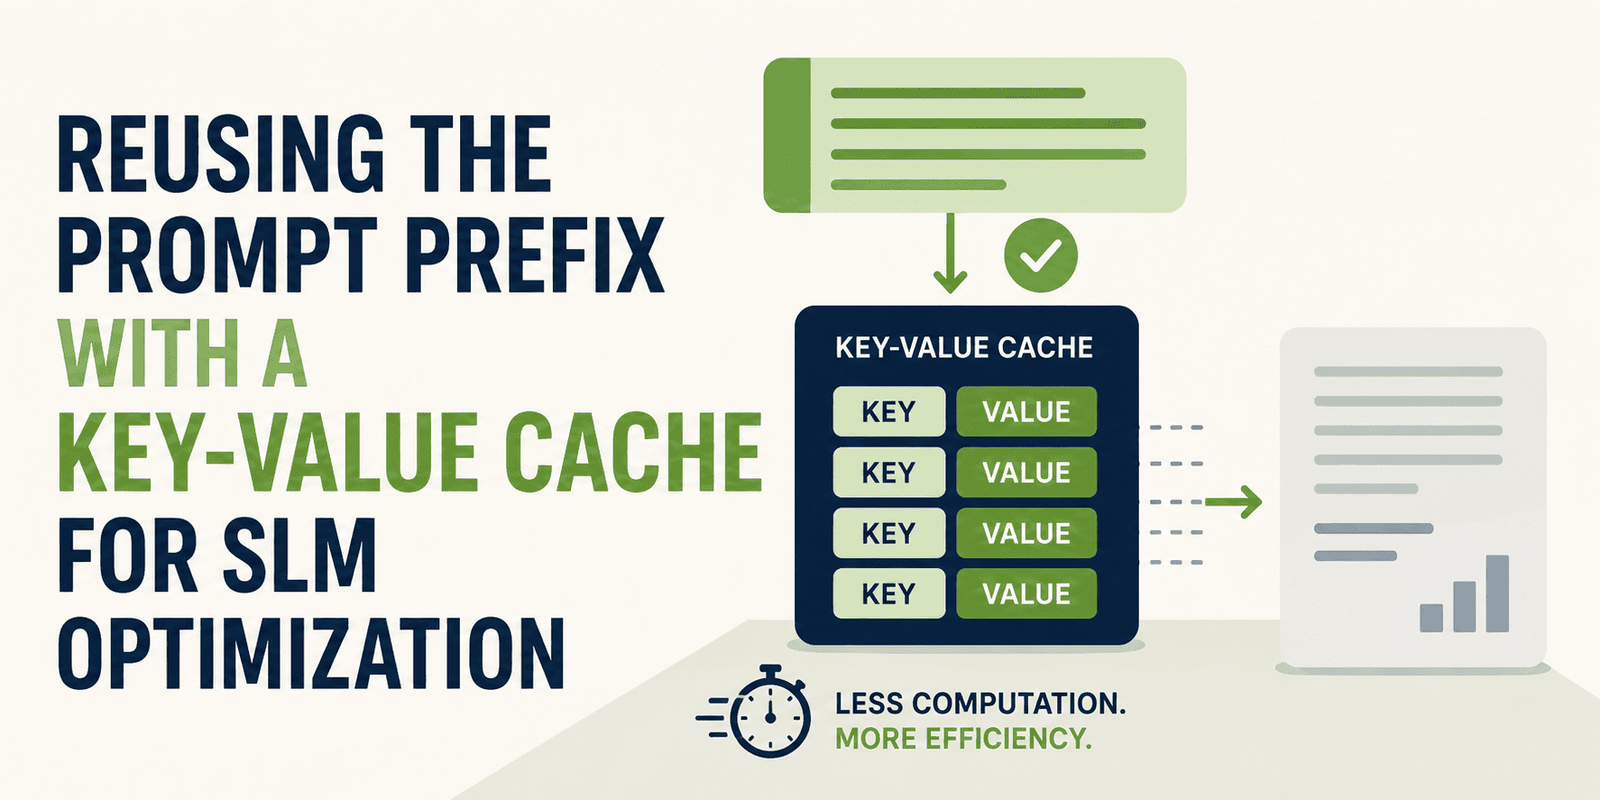
Otimização de SLMs: A Potência da Reutilização de Prefixo de Prompt com Cache Key-Value

No universo dinâmico da Inteligência Artificial, a eficiência e a velocidade são cruciais, especialmente quando falamos de Small Language Models (SLMs) e Large Language Models (LLMs). À medida que esses modelos se tornam mais integrados em diversas aplicações, a necessidade de otimizar sua performance e custo de inferência cresce exponencialmente.