A Inteligência Artificial (IA) tem transformado diversos setores, e os Large Language Models (LLMs), como ChatGPT, Gemini e Claude, estão no centro dessa revolução. No entanto, para aproveitar todo o potencial dessas ferramentas, é preciso ir além do básico. Um dos maiores desafios para desenvolvedores e empresas é o equilíbrio entre o custo das APIs, a qualidade das respostas e a eficiência das aplicações. É aqui que entra a otimização de prompts e a compressão de tokens, estratégias cruciais para quem busca construir soluções de IA mais inteligentes, rápidas e econômicas.
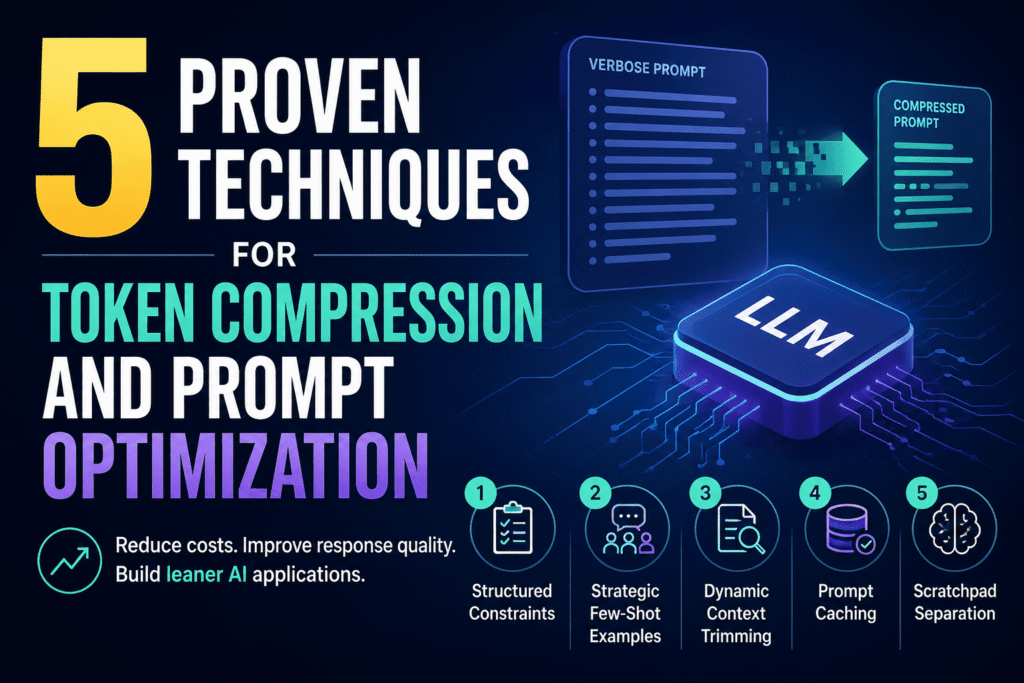
Neste artigo, vamos explorar cinco técnicas comprovadas de Prompt Engineering que podem transformar a maneira como você interage com os LLMs. Elas não apenas ajudam a reduzir custos, mas também melhoram significativamente a qualidade das saídas, resultando em aplicações de IA mais enxutas e eficazes.
O Desafio dos LLMs: Custo, Qualidade e o Contexto
Para entender a importância da otimização de prompts, é fundamental compreender como os LLMs funcionam e quais são suas limitações. Esses modelos processam informações em unidades chamadas tokens, que podem ser palavras inteiras, partes de palavras, ou até mesmo caracteres. A quantidade de tokens que um modelo consegue processar em uma única interação é definida por sua janela de contexto (context window).
O grande ponto é que o custo das APIs de LLMs é geralmente proporcional ao número de tokens utilizados, tanto na entrada (o prompt) quanto na saída (a resposta do modelo). Além disso, prompts muito longos podem diluir o foco do modelo, introduzir ruído e até mesmo levar a respostas menos precisas ou criativas. Gerenciar o uso de tokens é, portanto, um fator crítico para a viabilidade e o sucesso de qualquer aplicação baseada em LLMs.
Por Que a Otimização de Prompts é Essencial?
A otimização vai além de apenas escrever um bom prompt. Ela é uma abordagem estratégica que visa maximizar o valor de cada token enviado ao LLM. Os benefícios são claros:
Redução de Custos: Menos tokens significam menos gastos com as APIs dos provedores de LLMs. Para aplicações em escala, isso pode representar uma economia substancial.Melhora na Qualidade da Resposta: Prompts concisos e bem estruturados guiam o modelo de forma mais eficaz, levando a respostas mais relevantes, precisas e no formato desejado.Aumento da Velocidade de Processamento: Menos tokens para processar geralmente resultam em latências menores, melhorando a experiência do usuário.Aproveitamento Máximo da Janela de Contexto: Com prompts otimizados, é possível incluir mais informações *realmente relevantes* sem estourar o limite de tokens, enriquecendo o contexto para o modelo.
As 5 Técnicas Essenciais para Otimização de Prompts e Compressão de Tokens
Vamos mergulhar nas estratégias que podem levar suas interações com LLMs para o próximo nível.
1. Few-Shot Learning e Exemplos Concisos na Otimização de Prompts
O Few-Shot Learning é uma técnica poderosa onde você fornece ao LLM alguns exemplos de pares de entrada e saída para ensiná-lo o comportamento desejado. O segredo está em tornar esses exemplos o mais concisos e representativos possível.
Em vez de descrever extensivamente o que você quer que o modelo faça, mostre a ele com 2 a 5 exemplos claros. Por exemplo, se você quer que o modelo resuma textos, forneça alguns textos curtos com seus respectivos resumos. Isso economiza tokens e geralmente é mais eficaz do que longas instruções textuais. Escolha exemplos que cubram as variações mais importantes do seu caso de uso.
2. Summarization e Condensação de Contexto
Quando você tem um grande volume de texto que precisa ser analisado por um LLM, a técnica de summarization (resumo) é vital para a compressão de tokens. Em vez de passar o texto completo, você pode usar um LLM (ou até um modelo menor e especializado) para gerar um resumo conciso primeiro.
Isso pode ser feito de forma recursiva: se o texto for muito grande, resuma partes dele e depois junte os resumos para um resumo final. A ideia é extrair apenas as informações mais críticas, preservando o contexto necessário para a tarefa principal, sem sobrecarregar a janela de contexto do LLM final.
3. RAG (Retrieval-Augmented Generation) com Chunking Otimizado
O Retrieval-Augmented Generation (RAG) é uma técnica que permite aos LLMs acessar e utilizar informações externas ao seu treinamento. Em vez de tentar “ensinar” todo o seu conhecimento ao LLM através do prompt, você o conecta a uma base de dados (um “knowledge base” ou “vector database”) com seus documentos.
A chave para a compressão de tokens no RAG é o chunking otimizado. Seus documentos são divididos em “chunks” (pedaços) menores e relevantes. Quando o usuário faz uma pergunta, o sistema RAG recupera apenas os chunks mais relevantes dessa base de dados e os adiciona ao prompt do LLM. Isso evita enviar documentos inteiros e complexos, focando apenas no contexto necessário para a resposta, resultando em menor uso de tokens e maior precisão.
4. Prompt Chaining e Multi-Agent Systems
Tarefas complexas muitas vezes exigem prompts longos e multifacetados. Uma abordagem mais eficiente é o Prompt Chaining, onde você divide uma tarefa grande em uma série de subtarefas menores e sequenciais. Cada subtarefa é executada por um LLM com um prompt específico, e a saída de uma etapa se torna a entrada (otimizada e condensada) para a próxima.
Essa técnica é a base para Multi-Agent Systems (Sistemas Multi-Agente), onde diferentes “agentes” de IA, cada um com uma função específica (planejador, executor, revisor, etc.), colaboram para resolver um problema. Isso não só otimiza o uso de tokens ao gerenciar o contexto em cada etapa, mas também melhora a robustez e a capacidade de lidar com a complexidade.
5. Fine-tuning de Modelos Pequenos para Tarefas Específicas
Embora não seja uma técnica de compressão de prompts no sentido tradicional, o Fine-tuning de modelos menores é uma estratégia poderosa para reduzir a dependência de prompts complexos em LLMs maiores e mais caros. Em vez de usar um LLM genérico com um prompt extenso para cada tarefa específica, você pode treinar um modelo menor em um conjunto de dados especializado para aquela função.
Modelos menores e fine-tuned são mais eficientes, mais baratos de operar e exigem prompts muito mais simples (e curtos) para executar sua tarefa especializada. Isso é ideal para casos de uso repetitivos ou de alto volume, onde a economia de tokens e a performance são críticas. Essa abordagem pode complementar ou até substituir o uso intensivo de Prompt Engineering em cenários bem definidos.
Impacto no Desenvolvimento de Aplicações IA
A aplicação dessas técnicas de otimização de prompts tem um impacto profundo no ciclo de desenvolvimento de aplicações de IA. Startups e grandes empresas podem se beneficiar da seguinte forma:
Viabilidade Financeira: Reduzir custos de API torna os projetos de IA mais sustentáveis a longo prazo.Melhora na Experiência do Usuário: Respostas mais rápidas e precisas levam a produtos mais satisfatórios e engajadores.Escalabilidade: Aplicações mais eficientes consomem menos recursos, facilitando o escalonamento para um número maior de usuários ou interações.Agilidade no Desenvolvimento: Com prompts otimizados e técnicas como Prompt Chaining, é mais fácil iterar e melhorar as funcionalidades das aplicações.
Desenvolvedores que dominam essas estratégias se tornam profissionais mais valiosos, capazes de construir soluções de IA que são não apenas inovadoras, mas também economicamente viáveis e de alta performance.
O Futuro da Otimização de Prompts e a Evolução dos LLMs
Enquanto os LLMs continuam a evoluir, com janelas de contexto cada vez maiores e capacidades multimodais, a necessidade de otimização de prompts e compressão de tokens não vai desaparecer. Pelo contrário, ela se tornará ainda mais sofisticada. Técnicas como Retrieval e Fine-tuning se integrarão de forma ainda mais profunda, e novas ferramentas de automação de Prompt Engineering surgirão para facilitar o trabalho dos desenvolvedores.
Investir no aprendizado e aplicação dessas estratégias é fundamental para qualquer profissional ou empresa que deseja se manter na vanguarda da Inteligência Artificial. A era dos LLMs está apenas começando, e a eficiência será um diferencial competitivo.
Conclusão
A otimização de prompts e a compressão de tokens são pilares para a construção de aplicações de IA bem-sucedidas com Large Language Models. Ao aplicar técnicas como Few-Shot Learning, Summarization, RAG com chunking otimizado, Prompt Chaining e Fine-tuning, é possível reduzir custos, melhorar a qualidade das respostas e criar sistemas de IA mais ágeis e poderosos. Essas estratégias são indispensáveis para maximizar o potencial da IA generativa e garantir a sustentabilidade e eficácia de seus projetos.
FAQ: Perguntas Frequentes sobre Otimização de Prompts
O que é compressão de tokens?
Compressão de tokens refere-se a estratégias e técnicas utilizadas para reduzir o número de tokens (unidades de texto que os LLMs processam) enviados como entrada para um modelo de linguagem, sem perder a informação ou o contexto essencial. O objetivo é diminuir os custos da API, acelerar o processamento e melhorar a qualidade da resposta do LLM.
Como a otimização de prompts afeta o custo de APIs de LLMs?
A otimização de prompts impacta diretamente o custo das APIs de LLMs porque a maioria dos provedores cobra com base no número de tokens processados (entrada + saída). Ao otimizar seus prompts e comprimir tokens, você envia menos dados para o modelo, resultando em menor consumo de tokens e, consequentemente, em custos reduzidos. Para aplicações em larga escala, essa economia pode ser significativa.
Gostou da notícia?
Inscreva-se na nossa newsletter e receba as principais novidades sobre inteligência artificial diretamente no seu e-mail.
Fonte: https://www.kdnuggets.com