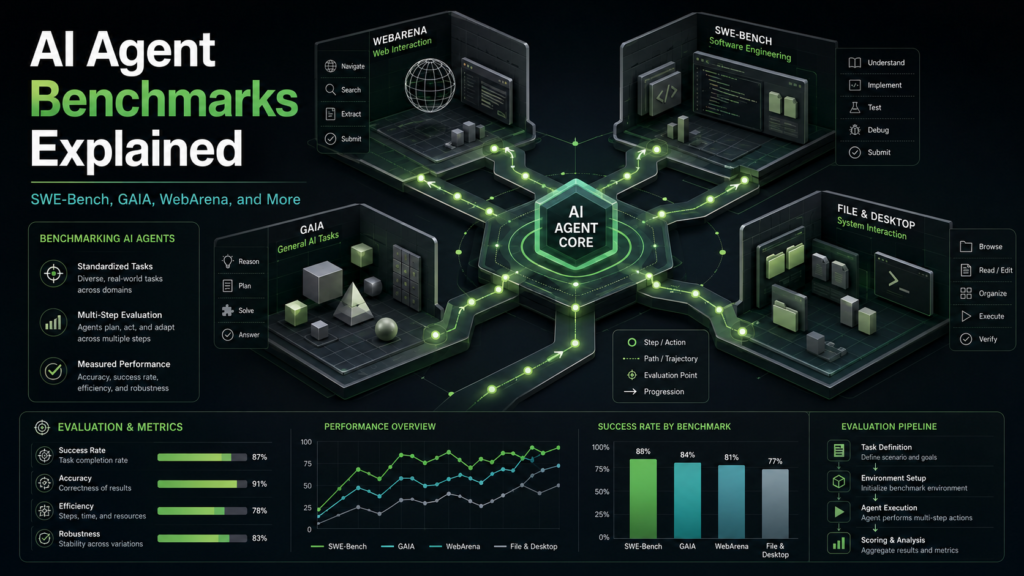
A Inteligência Artificial avança a passos largos, e um dos campos mais promissores é o dos Agentes de IA (AI Agents). Diferente dos Large Language Models (LLMs) que processam texto, os agentes de IA são projetados para interagir com ambientes, tomar decisões e executar tarefas complexas de forma autônoma. Mas como saber se um agente é realmente bom? É aqui que entram os Benchmarks para Agentes de IA, ferramentas cruciais para medir e comparar o desempenho dessas entidades inteligentes. Neste artigo, vamos mergulhar nos principais benchmarks do setor, como SWE-Bench, GAIA e WebArena, entender o que eles avaliam e por que são tão importantes para o futuro da IA.
O Que São Agentes de IA e Por Que Precisamos de Novos Benchmarks?
Os Agentes de IA são sistemas que percebem seu ambiente e agem para maximizar suas chances de atingir um objetivo. Eles podem planejar, interagir com ferramentas e até aprender com a experiência. Enquanto os LLMs se destacam em tarefas de linguagem, os agentes vão além, simulando comportamentos humanos em ambientes digitais ou físicos.
A necessidade de novos Benchmarks para Agentes de IA surge porque os métodos tradicionais de avaliação de LLMs (como MMLU, GLUE ou SuperGLUE), que focam em conhecimento estático e raciocínio textual, são insuficientes. Um agente precisa ser testado em sua capacidade de:
Planejamento e Execução: Dividir uma tarefa complexa em etapas menores e executá-las.Uso de Ferramentas: Integrar e operar com APIs, navegadores web, IDEs, etc.Adaptação ao Ambiente: Lidar com incertezas e mudanças no contexto.Raciocínio Multimodal: Processar e correlacionar informações de diferentes fontes (texto, imagens, código).Persistência: Manter o foco em uma tarefa ao longo do tempo.
Esses novos benchmarks visam capturar a robustez, a autonomia e a capacidade de resolução de problemas do mundo real dos agentes.
Comparando Benchmarks: Agentes x Modelos de Linguagem
Para entender a distinção, pense em um LLM como um cérebro extremamente inteligente que pode responder a qualquer pergunta com base em seu vasto conhecimento. Ele é avaliado pela precisão de suas respostas, sua coerência e sua capacidade de sumarizar ou gerar texto.
Um agente de IA, por outro lado, é esse cérebro equipado com braços e pernas, capaz de interagir com o mundo. Avaliar um agente não é apenas ver se ele ‘sabe’ a resposta, mas se ele consegue ‘fazer’ a tarefa. Isso envolve uma série de ações, desde pesquisar informações na web até escrever e depurar código, ou até mesmo manipular interfaces gráficas.
Os Benchmarks para Agentes de IA, portanto, introduzem cenários mais dinâmicos e abertos, onde o agente precisa demonstrar não só conhecimento, mas também estratégia, adaptabilidade e resiliência.
Principais Benchmarks para Agentes de IA: SWE-Bench, GAIA e WebArena
SWE-Bench: O Engenheiro de Software Autônomo
O SWE-Bench (Software Engineering Benchmark) é um dos mais renomados para avaliar agentes na área de engenharia de software. Ele desafia os agentes a resolverem problemas de software do mundo real, identificados a partir de issues de repositórios open-source como o popular GitHub.
O que mede: Capacidade de agentes de identificar e corrigir bugs, implementar novas funcionalidades e realizar refatorações complexas em bases de código existentes.Metodologia: Os agentes recebem uma descrição do problema (geralmente uma issue do GitHub), acesso a um ambiente de desenvolvimento (IDE), e devem gerar patches de código que resolvam o problema, passando pelos testes unitários correspondentes.Por que importa: É um teste rigoroso para a autonomia em desenvolvimento de software, replicando tarefas que exigem compreensão de código, planejamento de mudanças e depuração.
GAIA: A Generalista Inteligente em Tarefas do Dia a Dia
GAIA (General AI Agent) é um benchmark que testa a capacidade de agentes de IA em realizar tarefas do cotidiano que exigem raciocínio complexo, uso de ferramentas e navegação em ambientes online. As tarefas são formuladas para simular desafios enfrentados por humanos no dia a dia.
O que mede: Habilidade em resolver problemas abertos, que muitas vezes envolvem busca na web, análise de documentos, uso de calculadoras, edição de imagens e outras ferramentas.Metodologia: As tarefas são multimodais e podem exigir a combinação de diferentes tipos de informações. Por exemplo, encontrar uma informação em um PDF, pesquisar um dado complementar na web e calcular um resultado.Por que importa: Avalia a capacidade de agentes de integrar diversas habilidades e ferramentas para atingir objetivos complexos, aproximando-se da inteligência geral artificial.
WebArena: O Navegador Web Autônomo
O WebArena se concentra em testar agentes em um ambiente de navegação web realista. Ele simula interações com sites e aplicações online, replicando o comportamento de um usuário humano.
O que mede: Capacidade de agentes de navegar em sites, preencher formulários, fazer compras, interagir com interfaces de usuário complexas e extrair informações específicas.Metodologia: Agentes são colocados em um ambiente de navegador headless e recebem tarefas como ‘comprar um produto específico em um e-commerce’ ou ‘agendar um voo’. A avaliação é baseada na conclusão bem-sucedida da tarefa.Por que importa: É fundamental para o desenvolvimento de agentes que atuam como assistentes pessoais, bots de atendimento ao cliente ou automação de processos em empresas (RPA 2.0).
Como Usar os Benchmarks para Agentes de IA na Prática?
Para desenvolvedores e pesquisadores, os Benchmarks para Agentes de IA são ferramentas indispensáveis. Eles permitem:
Comparar Modelos: Obter uma métrica objetiva para comparar o desempenho de diferentes arquiteturas de agentes ou estratégias de Prompt Engineering.Identificar Fraquezas: Entender onde um agente falha (ex: planejamento, uso de ferramentas, raciocínio) e direcionar o desenvolvimento.Monitorar Progresso: Acompanhar a evolução das capacidades de um agente ao longo do tempo.Validar Pesquisas: Fornecer evidências empíricas da eficácia de novas abordagens ou algoritmos.
Ao escolher um benchmark, é crucial considerar o tipo de tarefa que o agente está sendo projetado para realizar. Um agente focado em automação de tarefas de software se beneficiará mais do SWE-Bench, enquanto um assistente pessoal geral poderia ser melhor avaliado pelo GAIA ou WebArena.
O Impacto Desses Benchmarks no Futuro da IA
A existência de benchmarks robustos impulsiona a pesquisa e o desenvolvimento. Eles criam um terreno comum para a comunidade de IA, permitindo que os avanços sejam medidos e validados de forma padronizada. Isso é vital para:
Democratização da IA: Ao facilitar a comparação, aceleram a adoção de técnicas mais eficazes.Inovação Contínua: Desafiam os pesquisadores a criar agentes cada vez mais capazes e autônomos.Confiança e Segurança: Agentes bem avaliados em benchmarks realistas tendem a ser mais confiáveis em aplicações práticas.Avanço em Áreas Específicas: Ao focar em domínios como software ou navegação web, esses benchmarks aceleram a criação de IA especializada de alto desempenho.
A capacidade de agentes de IA de resolver problemas complexos em ambientes digitais e interagir com ferramentas é um passo gigantesco em direção à Inteligência Artificial Geral (AGI). E os benchmarks são os faróis que guiam esse caminho, apontando para onde devemos focar nossos esforços e como medir nosso sucesso.
Para aprofundar seus conhecimentos sobre o tema, você pode consultar o artigo original sobre o WebArena no arXiv: WebArena: A Realistic Web Environment for Building Autonomous Agents.
Leia também: [LINK_INTERNO]
Conclusão
Os Benchmarks para Agentes de IA como SWE-Bench, GAIA e WebArena não são apenas métricas; são catalisadores para a próxima geração de sistemas inteligentes. Eles nos permitem ir além da mera proficiência textual dos LLMs, avaliando a capacidade de agentes de executar, planejar e interagir com o mundo de forma autônoma. À medida que esses agentes se tornam mais sofisticados, a qualidade e a complexidade dos benchmarks também precisarão evoluir, garantindo que a avaliação acompanhe o ritmo da inovação e nos ajude a construir IAs verdadeiramente úteis e poderosas.
FAQ: Perguntas Frequentes sobre Benchmarks para Agentes de IA
Qual a principal diferença entre um benchmark de LLM e um benchmark para Agentes de IA?
Enquanto os benchmarks de LLM avaliam principalmente a capacidade de um modelo de linguagem em raciocínio textual, geração de texto e compreensão de conhecimento, os benchmarks para Agentes de IA testam a habilidade de um agente em interagir com um ambiente, planejar, usar ferramentas e executar tarefas multi-etapas para alcançar um objetivo específico no mundo real (ou simulado). Eles medem a ‘capacidade de fazer’, não apenas a ‘capacidade de saber’.
Por que o SWE-Bench é considerado um benchmark tão desafiador para agentes de IA?
O SWE-Bench é desafiador porque utiliza problemas reais de engenharia de software (issues de GitHub) que exigem que o agente não apenas compreenda o código existente e a descrição do problema, mas também planeje uma solução, implemente mudanças, depure o código e garanta que as alterações passem nos testes. Isso simula um fluxo de trabalho complexo que exige uma compreensão profunda do domínio e a capacidade de interagir com ferramentas de desenvolvimento.
Gostou da notícia?
Inscreva-se na nossa newsletter e receba as principais novidades sobre inteligência artificial diretamente no seu e-mail.