A revolução da Inteligência Artificial, impulsionada pelos Large Language Models (LLMs), trouxe capacidades sem precedentes para a geração de texto. No entanto, o desafio de manter a factualidade e o acesso a informações atualizadas levou ao desenvolvimento do Retrieval Augmented Generation (RAG). Esta técnica combina a capacidade generativa dos LLMs com a recuperação de informações de uma base de conhecimento externa, minimizando alucinações e provendo respostas mais precisas.
Mas, assim como toda tecnologia, o RAG também evolui. Se o Naive RAG (ou RAG tradicional) representa a primeira onda, uma nova abordagem, o Agentic RAG, surge como uma evolução poderosa, prometendo transformar a forma como os sistemas de recuperação interagem com as fontes de dados. Este artigo detalha as diferenças, os pontos fortes e fracos de cada arquitetura, e como escolher a solução ideal para o seu projeto de IA.
O que é Retrieval Augmented Generation (RAG) e por que ele importa?
Antes de mergulharmos nas especificidades do Agentic RAG e do Naive RAG, é fundamental compreender o conceito básico de RAG. Em sua essência, RAG é um framework que melhora a capacidade de um LLM de gerar respostas informativas ao fornecer-lhe contexto relevante de fontes externas.
Funciona assim: quando um usuário faz uma pergunta, o sistema RAG primeiramente busca (retrieval) em uma base de dados (que pode ser um vetor database, documentos, artigos, etc.) informações que são relevantes para aquela pergunta. Em seguida, ele alimenta essas informações recuperadas (o ‘contexto’) junto com a pergunta original ao LLM. Com esse contexto adicional, o LLM é capaz de gerar uma resposta muito mais precisa e fundamentada, reduzindo a probabilidade de inventar fatos ou de se basear apenas em seu conhecimento pré-treinado, que pode estar desatualizado.
A importância do RAG reside em sua capacidade de:
Reduzir Alucinações: Fornecendo fatos verificáveis.Acessar Conhecimento Atualizado: Ultrapassando a data de corte do treinamento do LLM.Fornecer Transparência: Permitindo que os usuários vejam as fontes do contexto.Adaptar-se a Domínios Específicos: Sem a necessidade de fine-tuning custoso do LLM.
Naive RAG: A Abordagem Direta e Suas Limitações
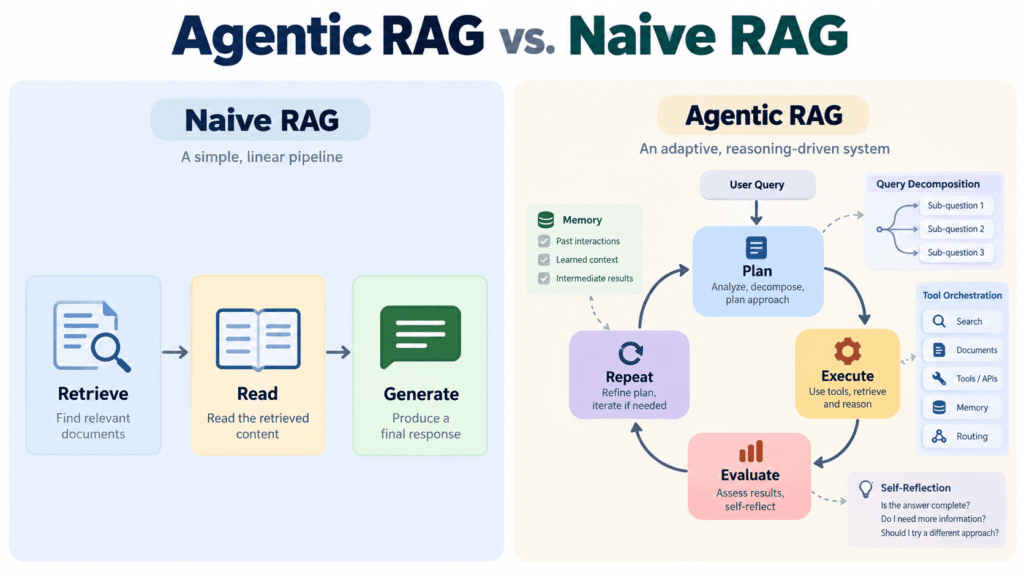
O Naive RAG, ou RAG tradicional, segue um fluxo de trabalho relativamente simples e linear. Ele se tornou a base para muitas aplicações de IA que buscam fornecer respostas factuais. Seu processo geralmente envolve:
Embeddings: Documentos da base de conhecimento são convertidos em vetores numéricos (embeddings) e armazenados em um banco de dados vetorial.Busca (Retrieval): A consulta do usuário é convertida em um embedding, e o sistema busca os documentos mais semanticamente semelhantes no banco de dados vetorial.Contexto: Os trechos de texto recuperados são anexados à consulta original do usuário, formando um ‘prompt’ estendido.Geração: Este prompt é então enviado ao LLM, que gera uma resposta com base nas informações fornecidas.
Pontos Fortes do Naive RAG
Simplicidade e Facilidade de Implementação: É relativamente simples de configurar e manter.Custo Efetivo: Menos intensivo em computação do que abordagens mais complexas ou fine-tuning.Boa Performance para Consultas Simples: Funciona bem para perguntas diretas onde a recuperação de alguns documentos relevantes é suficiente.
Onde o Naive RAG Fica Aquém
Apesar de suas vantagens, o Naive RAG possui limitações significativas, especialmente para casos de uso mais complexos:
Recuperação “Cega”: O sistema busca documentos apenas com base na semelhança da consulta, sem um entendimento mais profundo do que o LLM realmente precisa. Isso pode levar à recuperação de informações irrelevantes ou insuficientes.Falta de Raciocínio Iterativo: Não há um mecanismo para refinar a busca ou fazer várias perguntas à base de conhecimento se a primeira tentativa não for suficiente.“Overfitting” ao Contexto: O LLM pode se prender a uma informação específica recuperada, ignorando outras nuances ou a necessidade de uma visão mais abrangente.Dificuldade com Tarefas Multi-Etapa: Se uma pergunta exige raciocínio complexo ou a combinação de informações de várias fontes distintas de forma sequencial, o Naive RAG pode falhar.
Agentic RAG: Quando o Sistema de Recuperação Pensa por Si Mesmo
O Agentic RAG representa uma evolução significativa, incorporando a inteligência dos AI Agents (Agentes de IA) dentro do processo de RAG. Ao contrário do Naive RAG, onde o sistema é passivo na recuperação, o Agentic RAG é ativo e “inteligente”. Ele permite que o sistema não apenas recupere informações, mas também raciocine sobre elas, planeje suas ações e até mesmo se auto-corrija.
A ideia central é que, em vez de um fluxo linear, o processo de RAG se torna um ciclo de raciocínio e ação, orquestrado por um ou mais agentes de IA. Esses agentes podem:
Decompor Problemas: Dividir uma consulta complexa em sub-perguntas menores.Planejar a Recuperação: Decidir quais fontes consultar e como formular as buscas.Executar Múltiplas Buscas: Realizar várias etapas de recuperação, refinando cada busca com base nos resultados anteriores.Processar e Sintetizar: Analisar as informações recuperadas, identificar inconsistências e decidir se mais contexto é necessário.Usar Ferramentas (Tool Use): Além da busca, interagir com outras ferramentas (calculadoras, APIs, bases de dados específicas) para obter dados adicionais.Refletir e Auto-Corrigir: Avaliar a qualidade dos resultados da busca e da geração, e ajustar sua estratégia se necessário.
Como Funciona o Fluxo do Agentic RAG
Imagine um fluxo mais dinâmico para o Agentic RAG:
Consulta Inicial: O usuário faz uma pergunta.Agente de Planejamento: Um Agente de IA (powered by um LLM) analisa a consulta, quebra-a em passos e define uma estratégia de busca.Agente de Recuperação/Ferramentas: Este agente executa as buscas planejadas, usando embeddings para vetorizar sub-consultas e interage com as bases de dados ou outras ferramentas.Loop de Raciocínio: Os resultados são avaliados. Se incompletos ou inadequados, o agente pode reformular a pergunta, realizar novas buscas ou usar ferramentas adicionais. Isso é iterativo.Agente de Síntese: Após coletar informações suficientes e relevantes, um agente sintetiza o contexto final, que pode ser uma combinação de múltiplos documentos, dados de ferramentas e insights gerados.LLM Final: O contexto sintetizado é passado para o LLM principal para a geração da resposta final.
Vantagens do Agentic RAG
Raciocínio Avançado: Capacidade de lidar com perguntas complexas que exigem várias etapas de inferência e recuperação.Contexto Otimizado: Maior probabilidade de recuperar e utilizar informações verdadeiramente relevantes, reduzindo o “ruído”.Flexibilidade e Adaptabilidade: O sistema pode se adaptar a diferentes tipos de perguntas e fontes de dados dinamicamente.Maior Precisão: Melhora a qualidade e a factualidade das respostas geradas pelo LLM.Resolução de Problemas: Permite que o sistema “resolva” problemas em vez de apenas “responder” perguntas.
Desafios do Agentic RAG
Complexidade de Implementação: Requer um design mais sofisticado e a orquestração de múltiplos componentes.Latência Aumentada: As múltiplas etapas de raciocínio e recuperação podem aumentar o tempo de resposta.Custo Computacional: Mais chamadas ao LLM e uso de recursos para orquestração.Debugging e Observabilidade: Mais difícil de depurar e entender o fluxo de raciocínio do agente.Confiabilidade do Agente: A performance depende muito da capacidade do agente de planejar e executar suas ações de forma eficaz.
Agentic RAG vs. Naive RAG: Escolhendo a Abordagem Certa para Seu Projeto
A escolha entre Naive RAG e Agentic RAG não é uma questão de qual é inerentemente “melhor”, mas sim qual é o mais adequado para o seu caso de uso específico. Considere os seguintes pontos:
Quando Usar Naive RAG
Perguntas e Respostas Simples: Para chatbots de FAQ ou sistemas de busca que lidam com consultas diretas.Domínios Bem Definidos: Quando a base de conhecimento é homogênea e as respostas são geralmente encontradas em um ou poucos documentos.Baixa Latência é Crítica: Aplicações que exigem respostas quase instantâneas.Orçamento e Recursos Limitados: Para prototipagem rápida ou projetos com restrições de custo e complexidade.
Quando Optar por Agentic RAG
Raciocínio Complexo e Multi-Etapa: Para aplicações que exigem inferência profunda, combinação de informações de diversas fontes ou resolução de problemas.Bases de Conhecimento Heterogêneas: Quando o sistema precisa interagir com diferentes tipos de dados e ferramentas (bases de dados, APIs, web scraping).Alta Precisão e Factualidade: Em domínios onde erros são inaceitáveis (ex: saúde, finanças, jurídico).Sistemas Autônomos: Para agentes de IA que precisam tomar decisões e executar tarefas complexas sem intervenção humana.Pesquisa e Desenvolvimento: Para explorar os limites da IA e desenvolver novas capacidades.
Impacto no Desenvolvimento de Aplicações de IA e o Futuro
A ascensão do Agentic RAG representa uma mudança de paradigma no desenvolvimento de aplicações de IA. Para desenvolvedores, isso significa a necessidade de dominar não apenas os LLMs e o RAG básico, mas também os princípios de arquitetura de agentes, planejamento, uso de ferramentas e sistemas multi-agentes. As empresas, por sua vez, podem esperar ver um aumento na complexidade das soluções, mas também um salto qualitativo nas capacidades de seus assistentes de IA e sistemas de conhecimento.
O futuro do RAG provavelmente envolverá uma convergência de técnicas, onde o Naive RAG servirá como um componente base para tarefas simples, enquanto o Agentic RAG lidará com a orquestração e o raciocínio mais sofisticado. Veremos sistemas híbridos que combinam a velocidade do RAG tradicional com a profundidade e a flexibilidade dos agentes de IA, utilizando meta-raciocínio para decidir qual abordagem é melhor para cada etapa da consulta. A pesquisa em LLMs e agentes continua avançando rapidamente, tornando o campo do RAG um dos mais dinâmicos e promissores para a inovação em IA.
Para aprofundar seus conhecimentos em IA e como os LLMs estão sendo aplicados em diversos setores, confira nosso artigo sobre [LINK_INTERNO].
Conclusão
O debate entre Agentic RAG e Naive RAG é mais do que uma mera escolha técnica; é uma decisão estratégica que moldará a capacidade de suas aplicações de IA de entregar valor real. Enquanto o Naive RAG oferece uma solução eficaz e de baixo custo para muitas necessidades de recuperação, o Agentic RAG desbloqueia um novo nível de inteligência e autonomia, permitindo que os sistemas de IA não apenas busquem informações, mas as entendam, raciocinem sobre elas e atuem de forma mais “humana”. Ao entender as nuances de cada abordagem, você estará mais bem equipado para construir a próxima geração de aplicações de IA poderosas e confiáveis.
Para mais informações sobre o desenvolvimento e os avanços em RAG e sistemas de agentes, você pode consultar recursos como a documentação oficial de frameworks como LangChain ou LlamaIndex, que implementam muitas dessas ideias. Visite o site do LlamaIndex para aprender mais.
FAQ: Perguntas Frequentes sobre RAG
1. Qual é a principal diferença entre Agentic RAG e Naive RAG?
A principal diferença reside na capacidade de raciocínio e ação do sistema. O Naive RAG segue um fluxo linear e passivo de busca e geração. Já o Agentic RAG incorpora agentes de IA que podem planejar, executar múltiplas buscas iterativas, usar ferramentas, processar informações e até mesmo refletir e se auto-corrigir antes de gerar a resposta final, resultando em um raciocínio mais complexo e adaptável.
2. Quando devo escolher Naive RAG em vez de Agentic RAG?
O Naive RAG é ideal para cenários onde as consultas são simples e diretas, a base de conhecimento é bem definida, a latência de resposta é crítica e o orçamento ou a complexidade de implementação precisam ser mantidos baixos. Para chatbots de FAQ, busca de documentos básicos ou sistemas que não exigem raciocínio complexo, o Naive RAG oferece uma solução eficiente e suficiente.
Gostou da notícia?
Inscreva-se na nossa newsletter e receba as principais novidades sobre inteligência artificial diretamente no seu e-mail.
Fonte: https://www.kdnuggets.com